Détecteurs de texte IA (Pangram, GPTZero, Turnitin, Compilatio) : comment fonctionnent-ils et que valent-ils ?
Par AnthonyR · Publié le · Mis à jour le
Pangram, GPTZero, Turnitin, Compilatio : comment les détecteurs de texte IA calculent leur score, ce que disent les études indépendantes et comment le lire.
En bref
- Un détecteur de texte IA calcule une probabilité, à partir du style, que le texte ait été produit par un modèle de langage. Ce n’est jamais une preuve.
- Les meilleurs outils font peu de faux positifs en anglais : dans une étude indépendante de Chicago Booth publiée en 2025, Pangram, GPTZero et Originality.ai restent sous 1 % de textes humains classés à tort comme IA.
- Les échecs sont documentés : OpenAI a retiré son propre détecteur en juillet 2023, et une étude de Stanford a montré en 2023 que sept détecteurs classaient à tort plus de la moitié d’essais écrits par des non-anglophones.
- Les textes courts, retravaillés ou « humanisés », et les langues autres que l’anglais restent les points faibles, et les évaluations indépendantes sur la prose littéraire française manquent.
- Le filigrane SynthID Text de Google marque le texte dès sa génération, mais seulement pour les modèles qui l’utilisent.
- Un score se lit comme un indice, à croiser avec l’historique du texte, ses versions successives et les explications de l’auteur.
Comment un détecteur reconnaît-il un texte généré ?
Deux familles d’outils coexistent. La première, statistique, mesure à quel point un texte est « prévisible » pour un modèle de langage. GPTZero, lancé en janvier 2023, a popularisé deux notions. La perplexité mesure, selon son éditeur, la probabilité qu’un modèle d’IA ait choisi exactement les mêmes mots que ceux du document : un texte très prévisible a une perplexité basse. La « burstiness » mesure à quel point cette perplexité varie d’une phrase à l’autre. Un humain alterne des phrases banales et des phrases surprenantes, alors qu’un modèle garde un niveau de ressemblance à l’IA « très constant », explique GPTZero.
GPTZero précise toutefois qu’il n’utilise plus la perplexité et la burstiness depuis l’automne 2023, après être passé à une architecture d’apprentissage profond. La plupart des détecteurs commerciaux actuels relèvent de cette seconde famille : des classifieurs, c’est-à-dire des réseaux de neurones entraînés sur des milliers d’exemples étiquetés « humain » ou « IA », qui apprennent eux-mêmes les régularités distinctives. Compilatio, éditeur basé à Annecy, décrit ainsi son moteur comme un modèle de langage « spécifiquement entraîné » à reconnaître une production humaine ou artificielle.
Quelle est la méthode de Pangram ?
Pangram, l’outil au centre de l’affaire du Goncourt 2026, a détaillé sa méthode dans un rapport technique déposé sur arXiv en février 2024 par Bradley Emi et Max Spero. Le détecteur est un réseau de neurones de type transformeur. Pour chaque texte humain de son corpus d’entraînement, l’équipe fait écrire par un modèle de langage un « miroir synthétique » : un texte généré sur le même sujet et de la même longueur, par exemple un avis de même note sur le même restaurant. Le classifieur apprend ainsi à distinguer l’auteur plutôt que le sujet.
Le second ingrédient est le « hard negative mining ». Après un premier entraînement, le modèle analyse un grand réservoir de textes humains, repère ceux qu’il classe à tort comme IA, puis les ajoute à l’entraînement avec leurs miroirs. Le rapport justifie ce choix contre les méthodes fondées sur la perplexité, qui échouent selon les auteurs sur des textes humains présents dans les données d’entraînement des modèles, comme la Déclaration d’indépendance américaine. Pangram y affirme aussi ne pas être biaisé contre les non-anglophones et avoir étendu l’outil à d’autres langues en juillet 2024.
Le rapport « Pangram 4 », publié le 29 juillet 2026, annonce un taux de faux positifs de 0,0041 % et un taux de faux négatifs de 0,3396 %, ainsi qu’une meilleure détection des textes mêlant écriture humaine et IA. Ces chiffres sont publiés par l’éditeur lui-même.
Que valent les chiffres annoncés par les éditeurs ?
Chaque éditeur publie un taux de faux positifs flatteur. Pangram estime sur son site, selon Radio-Canada, ce taux à environ 1 sur 10 000 au 15 septembre 2026, et à 0,003 % pour les livres. Compilatio annonce une fiabilité de 94 à 99 % sur des contenus académiques et un taux de faux positifs inférieur à 1 %, mesurés sur environ 7 400 textes dans 24 langues, dont le français, pour sa version 4.5.3 en service depuis le 4 septembre 2025. L’éditeur précise que les textes IA de ce test ont été produits avec des questions simples, « sans instructions spécifiques » de style : un cas plus facile que celui d’un texte volontairement retravaillé. En juillet 2025, le Journal du Net jugeait « un peu optimistes » les 98,5 % de précision alors revendiqués par Compilatio, avancés « sans audit externe ni papier de recherche ».
Lucide.ai, détecteur spécialisé dans le français, a publié en juillet 2026 une comparaison sur 11 000 textes en français. Sur les textes entièrement humains, l’éditeur mesure 100 % de bonnes réponses pour son outil, 99 % pour Pangram et 96 % pour GPTZero ; sur les textes mêlant humain et IA, Pangram tombe à 60 % et GPTZero à 54 %, selon la même étude. Ces résultats sont intéressants parce qu’ils portent sur le français, mais ils émanent d’un concurrent qui se classe premier de son propre test.
Turnitin, éditeur de logiciels anti-plagiat pour l’enseignement, a lancé son détecteur en avril 2023 en promettant moins de 1 % de faux positifs. Quelques semaines plus tard, sa directrice produit Annie Chechitelli a nuancé ce chiffre, rapporte Inside Higher Ed le 1er juin 2023 : il ne vaut que pour les documents contenant au moins 20 % d’écriture IA, et le taux de faux positifs au niveau de la phrase est d’environ 4 %. Turnitin a ajouté un astérisque aux scores inférieurs à 20 %, jugés moins fiables.
Que disent les études indépendantes ?
Le premier signal d’alarme est venu d’OpenAI. Son AI Classifier, lancé le 31 janvier 2023, ne reconnaissait sur un jeu de test en anglais que 26 % des textes générés, et classait à tort 9 % des textes humains comme IA. OpenAI le disait « très peu fiable » sous 1 000 caractères, déconseillait de l’utiliser hors de l’anglais, puis l’a retiré le 20 juillet 2023 « en raison de son faible taux de précision ».
En 2023, l’équipe de James Zou, à l’université Stanford, a soumis à sept détecteurs populaires 91 essais rédigés en anglais par des non-anglophones pour le test TOEFL. Les détecteurs en ont classé plus de la moitié comme générés, et l’un d’eux près de 98 %, alors que plus de 90 % des essais d’élèves américains de quatrième étaient correctement reconnus. L’explication tient à la perplexité : un vocabulaire simple et courant paraît « prévisible », donc artificiel. Après réécriture de ces essais par ChatGPT dans un vocabulaire plus recherché, les détecteurs les ont jugés humains. L’étude, publiée dans la revue Patterns, déconseille ces outils dans les contextes d’évaluation.
Une étude de 2024 menée par Mike Perkins et ses collègues de la British University Vietnam a testé six détecteurs majeurs sur 805 analyses. Leur précision, déjà basse (39,5 %), tombait à 17,4 % face à des textes générés puis modifiés avec des techniques simples de contournement.
L’évaluation la plus favorable aux détecteurs est celle de Brian Jabarian et Alex Imas, de l’université de Chicago (Booth School of Business), publiée en 2025 comme document de travail du NBER. Les chercheurs ont constitué environ 2 000 textes humains (blogs, avis de consommateurs, articles de presse, extraits de romans, avis de restaurants, CV) et leurs équivalents générés par quatre modèles. Les trois outils commerciaux gardent un taux de faux positifs inférieur à 1 %, celui de Pangram étant quasi nul ; les faux négatifs vont de 0 à 2 % pour GPTZero, de 2 à 4 % pour Pangram, et de 10 à 40 % pour Originality.ai. Le détecteur libre RoBERTa, proche du hasard, est jugé « inadapté aux usages à fort enjeu ». Les auteurs concluent que Pangram est le seul outil à respecter un plafond strict de 0,5 % de faux positifs, tout en prévenant d’une « course aux armements technique » avec les outils de réécriture. Le résumé de Chicago Booth ne mentionne pas de textes en français.
Où les détecteurs se trompent-ils le plus ?
Les textes courts sont le premier point faible. Dans l’étude de Chicago Booth, les trois outils commerciaux perdent en précision sous 50 mots, et OpenAI jugeait son classifieur peu fiable sous 1 000 caractères.
Les textes retravaillés viennent ensuite. Les « humanizers », services qui réécrivent un texte généré pour échapper à la détection, et les simples modifications testées par Perkins font chuter la précision de nombreux outils. Jabarian et Imas estiment Pangram robuste face aux humanizers testés, mais recommandent des audits réguliers. Les textes mixtes posent un problème voisin : Turnitin constate que 54 % des phrases humaines signalées à tort se trouvent juste à côté de passages réellement générés.
Les langues autres que l’anglais et les registres particuliers forment la troisième zone de doute. Le rapport de Pangram évalue ses performances multilingues sur des avis Amazon, des résumés d’articles de presse et Wikipédia, pas sur des romans. Dans l’affaire Orélien, les Éditions du Boréal ont précisément contesté un outil dont la fiabilité n’a, selon elles, « jamais été établie sur la prose romanesque francophone ».
Et les filigranes, comme SynthID Text ?
Le filigrane prend le problème à l’envers : au lieu de deviner après coup, il marque le texte au moment où le modèle l’écrit. SynthID Text, de Google DeepMind, modifie légèrement la probabilité de choix des mots pendant la génération, ce qui laisse une signature statistique invisible au lecteur mais repérable par un détecteur dédié. Google l’a rendu open source en octobre 2024, rapporte la MIT Technology Review, après l’avoir testé sur environ 20 millions de réponses de Gemini sans baisse de qualité perçue par les utilisateurs.
Le système a trois limites, selon la même source : il ne fonctionne que pour les modèles qui l’intègrent, il résiste mal à une réécriture poussée ou à une traduction, et il est moins fiable sur les réponses factuelles, où peu de formulations sont possibles. L’article 50 de l’AI Act impose par ailleurs aux fournisseurs d’IA un marquage lisible par machine des contenus générés, détaillé dans notre guide sur la divulgation des œuvres selon l’AI Act. Pour les images, voir comment reconnaître une image générée.
Qui utilise ces détecteurs, et avec quelles conséquences ?
Dans les universités, Turnitin et Compilatio servent à analyser les copies des étudiants. Certains établissements ont reculé. L’université Vanderbilt a désactivé le détecteur de Turnitin le 16 août 2023 : elle avait soumis 75 000 copies à Turnitin en 2022, et un taux de 1 % de faux positifs aurait pu faire soupçonner à tort environ 750 étudiants. L’université reprochait aussi à Turnitin de ne donner aucune information détaillée sur sa méthode.
L’édition s’y est mise à son tour. Selon Radio-Canada, Hachette a retiré en mars 2026 le roman d’horreur Shy Girl quelques jours avant sa sortie américaine, après une analyse de Pangram. En septembre 2026, le détecteur a déclenché l’affaire du roman C’était ça ou mourir de Thélyson Orélien. Le 21 septembre, le compte anonyme « Balance ton Claude » publie sur X des analyses d’extraits jugés « 100 % IA » par Pangram, et des textes de l’auteur datés de 2014 notés 0 %. L’auteur et son éditeur démentent. Le 25 septembre, l’Académie Goncourt retire le livre de sa sélection, en estimant, selon franceinfo, qu’il est « selon toute vraisemblance très largement le produit d’une intelligence artificielle », sur la base du « résultat convergent de plusieurs analyses ».
Comment interpréter un score de détection ?
Un score de 90 % ne signifie pas « 90 % du texte a été écrit par une IA », ni « il y a 90 % de chances que l’auteur ait triché ». Il exprime la confiance du modèle dans l’une de ses deux étiquettes, pour un texte donné, dans les conditions de ses données d’entraînement. Turnitin conseille ainsi de considérer les phrases surlignées comme des « zones d’intérêt » et d’utiliser l’information « pour ouvrir une conversation, pas pour tirer une conclusion ».
Le volume d’analyses compte aussi. Même avec le taux revendiqué par Pangram, 1 faux positif sur 10 000, un comité qui analyserait 10 000 manuscrits entièrement humains devrait s’attendre à environ une fausse alerte. Le calcul de Vanderbilt montre qu’avec 1 %, les erreurs se comptent par centaines.
Un faisceau d’indices vaut mieux qu’un score isolé. Les éléments qui ont pesé dans les cas documentés sont extérieurs au détecteur : versions successives du manuscrit et échanges avec l’éditeur, comme l’invoque le Boréal ; comparaison avec des textes antérieurs de l’auteur, que recommande Vanderbilt ; capacité de l’auteur à expliquer sa démarche, que conseille Turnitin ; convergence de plusieurs outils indépendants. Notre guide sur les accusations d’IA erronées détaille des cas où ces traces ont blanchi des créateurs. Pour tester votre propre œil, voir le quiz IA ou pas IA.
Fiches liées
C'était ça ou mourir (Thélyson Orélien)
Niveau : VampiriséStatut : SoupçonnéC'est contesté. Le 25 septembre 2026, l'Académie Goncourt a retiré de sa première sélection le roman C'était ça ou mourir, de l'écrivain canado-haïtien Thélyson Orélien, qu'elle juge « selon toute vraisemblance très largement le produit d'une intelligence artificielle ». L'auteur et les Éditions du Boréal démentent fermement tout recours à l'IA.
Faux livres attribués à Jane Friedman
Niveau : VampiriséStatut : SoupçonnéTrès probablement. En août 2023, l'autrice Jane Friedman a découvert environ six livres vendus sur Amazon sous son nom, qu'elle n'avait pas écrits et qu'elle estime générés par IA. Amazon a d'abord refusé de les retirer faute de marque déposée, puis les a supprimés le 8 août après la médiatisation de l'affaire.
Guides de cueillette de champignons vendus sur Amazon (2023)
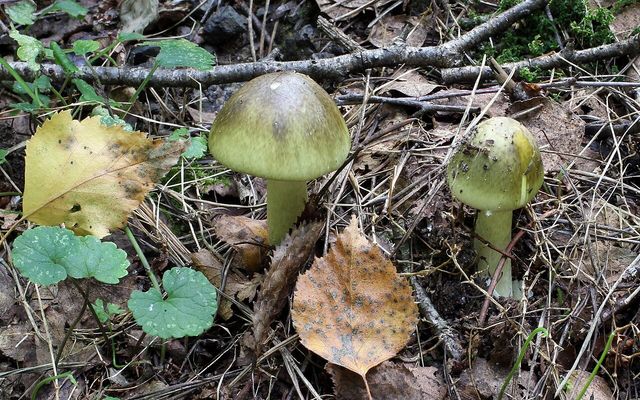
Niveau : VampiriséStatut : SoupçonnéTrès probablement. En août 2023, la New York Mycological Society a alerté sur des guides de cueillette de champignons vendus sur Amazon et vraisemblablement écrits par IA, sous des noms d'auteurs apparemment inventés. Une erreur d'identification pouvant être mortelle, elle a parlé d'une question de « vie ou de mort ».
Fire and Fury: The Story of the 2023 Maui Fire (livre retiré d'Amazon)
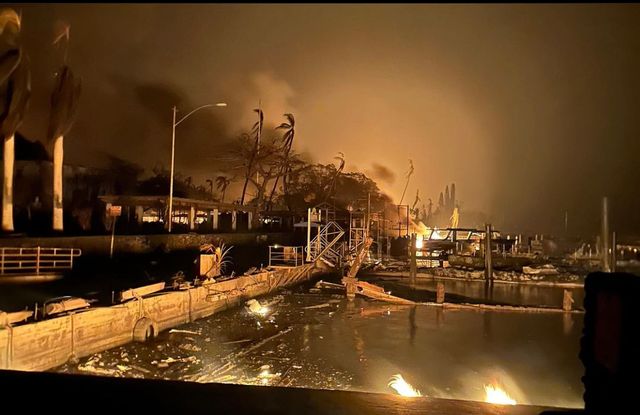
Niveau : VampiriséStatut : SoupçonnéTrès probablement. Publié sur Amazon le 10 août 2023, deux jours après le début des incendies de Maui qui ont détruit Lahaina, un livre signé d'un introuvable « Dr. Miles Stones » est brièvement devenu une meilleure vente de sa catégorie. Lecteurs et presse y ont vu un texte généré par IA ; il a été retiré de la vente.
Questions fréquentes
Un détecteur de texte IA peut-il prouver qu'un texte a été écrit par une IA ?
Non. Un détecteur produit une probabilité fondée sur le style du texte, pas une preuve. Turnitin recommande lui-même d'utiliser son score pour « ouvrir une conversation », pas pour conclure.
Quel est le détecteur de texte IA le plus fiable ?
Dans l'étude indépendante de Brian Jabarian et Alex Imas (Chicago Booth, 2025), Pangram obtient les meilleurs résultats sur les faux positifs, devant GPTZero et Originality.ai. Cette étude ne porte pas sur la prose littéraire en français, et les performances évoluent avec chaque nouveau modèle d'IA.
Les détecteurs d'IA fonctionnent-ils en français ?
Pangram, Compilatio et Lucide.ai revendiquent une détection en français, mais les chiffres publiés viennent surtout des éditeurs eux-mêmes. Aucune évaluation indépendante sur la prose romanesque francophone n'a été trouvée par Draculia.
Pourquoi OpenAI a-t-il retiré son détecteur de texte ?
OpenAI a retiré son AI Classifier le 20 juillet 2023 « en raison de son faible taux de précision ». Au lancement, il ne reconnaissait que 26 % des textes générés et classait à tort 9 % des textes humains.
Qu'est-ce que SynthID Text ?
Un filigrane invisible de Google DeepMind, inséré au moment de la génération en modifiant la probabilité des mots choisis. Rendu open source en octobre 2024, il ne marque que les textes des modèles qui l'intègrent et résiste mal à la réécriture ou à la traduction.
Sources
- New AI classifier for indicating AI-written text, OpenAI, . Déclaration officielle
- What is perplexity & burstiness for AI detection?, GPTZero, . Déclaration officielle
- GPT detectors are biased against non-native English writers, arXiv (Université Stanford, publié dans Patterns), . Autre
- GPT detectors can be biased against non-native English writers, ScienceDaily (communiqué de Cell Press), . Presse
- Technical Report on the Pangram AI-Generated Text Classifier, arXiv (Pangram Labs), . Déclaration officielle
- Pangram 4 Technical Report, arXiv (Pangram Labs), . Déclaration officielle
- Artificial Writing and Automated Detection, National Bureau of Economic Research, . Autre
- Do AI Detectors Work Well Enough to Trust?, Chicago Booth Review, . Presse
- GenAI Detection Tools, Adversarial Techniques and Implications for Inclusivity in Higher Education, arXiv (International Journal of Educational Technology in Higher Education), . Autre
- Understanding AI writing detection: False positive rates, Turnitin, . Déclaration officielle
- Turnitin's AI detector: higher-than-expected false positives, Inside Higher Ed, . Presse
- Guidance on AI Detection and Why We're Disabling Turnitin's AI Detector, Université Vanderbilt, . Déclaration officielle
- How reliable is the Compilatio AI detector?, Compilatio, . Déclaration officielle
- 98,5% de précision : Compilatio peut-il vraiment identifier les textes générés par IA ?, Journal du Net, . Presse
- Étude Lucide.ai 2026 : précision des détecteurs d'IA en français, Lucide.ai, . Déclaration officielle
- Google DeepMind is making its AI text watermark open source, MIT Technology Review, . Presse
- Thélyson Orélien nie avoir utilisé l'IA pour écrire son roman C'était ça ou mourir, Radio-Canada, . Presse
- Le roman de Thélyson Orélien supprimé de la sélection du prix Goncourt en raison de soupçons de recours à l'intelligence artificielle et d'accusations de plagiats, franceinfo, . Presse